假如 我们已经建立了一个网站——投入了设计精力、购买了域名等等。但网站不仅仅是在屏幕上所看到的内容,其背后还涉及许多运作机制。这就需要了解互联网是如何运作的,以及搜索引擎优化(SEO)的原理。
网站速度是一个关键因素。如果网站加载缓慢,其 SEO 表现往往会很差,因为在当今环境下,大多数用户都不愿花太多时间等待页面加载。其中包含许多需要考量的指标,例如”最大内容渲染时间”(LCP)、”累积布局偏移”(CLS)以及服务器响应速度等。
如果网站速度尚可,那么影响 SEO 的因素就涉及到网站本身。本文主要关注的就是那些阻碍搜索引擎访问和读取网页的问题。
在我看来,技术性 SEO 比侧重于内容和关键词的常规 SEO 更具挑战性。技术层面通常需要开发人员的专业知识;如果缺乏技术背景,其中一些必要的调整可能会让人感到有些棘手。
技术性问题往往会长期存在却不被察觉,因为它们并非显而易见的设计缺陷。这通常只有在进行专门的检测(例如使用 Google PageSpeed Insights)时,才能发现这些问题。
在本教程中,我们将通过一个小型练习网站,来找出并修复其中最常见的一些技术性 SEO 问题。
准备工作
无需具备丰富的编程经验即可跟随本教程进行操作。但需要准备以下内容:
- 一款网页浏览器,例如 Chrome、Firefox、Edge 或 Safari。如果使用 Safari,请先在”设置 > 高级”中勾选”显示网页开发功能”
- 一个终端:macOS 上的”终端”(Terminal)、Windows 上的 PowerShell,或 Linux 系统中的任意终端
- curl:一个用于下载网页的小工具。macOS、大多数 Linux 发行版,以及 Windows 10(1803 及更高版本)和 Windows 11 系统均已内置该工具
- Node.js:用于运行练习站点。本教程中的代码已在 Node.js 26.8 和 curl 8.7 环境下经过测试
在 Windows PowerShell 中,需要使用 curl.exe 代替 curl,因为在 PowerShell 中,curl 是另一个命令的快捷方式。此外,还需要将”| grep -i “text” ” 替换为”| Select-String “text” “,并将”/dev/null”替换为”NUL”。
技术型 SEO 的概念
Google 拥有一种被称为”爬虫”(crawlers)的程序。它们会持续在互联网上搜寻新的网站和页面。当 Google 发现一个新网址时,它可能会抓取该页面,并处理其中的内容(包括文本、图片和视频)。
如果 Google 认为该页面值得被收录,就会将其加入到一个庞大的网页数据库中,这个数据库被称为”索引”(index)。当用户进行搜索时,Google 会从索引中筛选出与搜索内容相关的页面,并将其呈现为搜索结果。在 Google 关于搜索工作原理的指南中,这三个步骤分别被称为:抓取(crawling)、索引(indexing)和呈现(serving)。
因此,被抓取并不保证一定会被索引,而被索引也不保证一定能出现在搜索结果中。该指南还指出,即便某个页面完全遵循了 Google 的所有规则,Google 也无法保证一定会完成这三个阶段中的任何一个。
解决技术问题未必能让网站在 Google 搜索中排名第一,但它确实能增加获得更高排名的机会,因为每解决一个问题,网站质量都会得到提升。
技术型 SEO 必须与常规 SEO(如关键词优化、反向链接、社交媒体互动等)相结合,才能发挥作用。
实际网站中的常见问题
常见的网站技术性 SEO 问题如下:
- 至少有一个页面缺少规范标签(canonical tag)
- 有两个或更多页面标题完全相同
- 至少有一个页面缺少元描述(meta description)
- 至少有一个链接指向返回 404 状态码的页面
- 主要由 JavaScript 构建的页面
- 至少有一个页面缺少标题(title)
- 搜索引擎可能无法跟踪的链接
- robots.txt 文件存在错误或无法加载
- 存在被 noindex 标签或 robots.txt 文件阻止的页面
这些都属于技术性问题,但它们的重要性各不相同。缺少规范化标签(canonical tag)的问题最为关键;不过,由于谷歌并不强制要求必须设置规范化标签,因此即便页面缺少该标签,本身也并不算”出故障”。但当相同或高度相似的内容可以通过多个不同的网址(URL)访问时,这个问题就变得重要了。
标题重复也是经常遇到过的问题:在编写代码时,很容易忽略这类细节。正因如此,才有了专门用于检测此类问题的工具。
让我们逐一梳理以上各项问题,确保大家都能理解清楚:
- 缺少规范标签(Canonical Tag):规范标签本质上是 HTML 中”<head>”部分包含的众多标签之一。当两三个页面的内容高度相似时,它能告知 Google 等搜索引擎,哪个 URL 才是原始的、主要的版本(即你希望被索引的版本)。当然,它并非强制要求;即便没有它,Google 也会自行判断并选定主要版本。因此,该标签主要针对存在重复内容的页面才有意义
- 标题重复:不同页面使用相同的标题非常容易发生。应避免标题重复,因为这不仅毫无益处,还可能让 Google 感到困惑。每个页面都应明确体现其自身的主题内容
- 缺少元描述(Meta Description):这一点非常重要,因为它不仅对搜索引擎有帮助,对 ChatGPT 等人工智能工具也同样有用。元描述的作用是简要说明页面的主题及其用途。当我们在 Google 上搜索某个网站时,它会显示在搜索结果中该网站链接的下方
- 指向 404 页面的链接:这通常意味着存在”死链”(即指向已不存在页面的链接,可能是一些不再使用的链接)。显然,链接指向一个不存在的页面是没有意义的。建议将其修改为指向内容相似或确实存在的页面,以确保链接的有效性和相关性
- 主要由 JavaScript 构建的页面:Google 能够执行 JavaScript,因此仅凭这一点并不会导致页面无法被 Google 收录。但由于内容必须在 JavaScript 加载并运行后才会显示,这不仅会拖慢访客的访问速度,还增加了一个可能出错的环节;此外,并非所有爬虫都能执行 JavaScript。因此,对于核心内容,应该更倾向于使用”服务端渲染”(Server-Side Rendering)
- 搜索引擎无法追踪的链接:这并非什么严重的问题,具体影响取决于链接指向的位置。但假设我们写了一篇非常优质的文章,并希望它能帮助在 Google 搜索中获得更好的排名……如果搜索引擎无法通过链接访问到某篇文章,那么之前投入大量时间和精力撰写的这篇文章,恐怕就没几个人能看到了
- robots.txt 文件中的错误:robots.txt 本质上是网站与搜索引擎沟通的桥梁。如果该文件存在错误,可能会导致搜索引擎无法抓取我们希望出现在搜索结果中的页面
- 被 noindex 或 robots.txt 屏蔽的页面:这是两种不同的情况。noindex 规则会要求搜索引擎不要将页面纳入搜索结果,而 robots.txt 规则则是禁止搜索引擎抓取该页面
“软 404″(Soft 404)、重定向链以及错误的规范标签(canonical tags)虽然并未在之前列出,但也是常常出现的问题。
搭建练习站点
该练习站点是一个小型网站,模拟了一家名为”Acme Shoes”的虚构鞋店。网站的每个页面中都预设了一个问题,但无需理解代码中的每一行。
创建一个新文件夹,在其中添加一个名为”server.js”的文件,主要代码如下:
// server.js: a tiny practice site with common technical SEO problems built in
const http = require('node:http');

const PORT = 8080;
const BASE = 'http://localhost:' + PORT;

// Builds a simple HTML page. Leave out a field to leave that tag out.
function page({title, description, canonical, robots, body, script}) {
    return [
        '<!doctype html>',
        '<html lang="en">',
        '<head>',
        '<meta charset="utf-8">',
        title && '<title>' + title + '</title>',
        description && '<meta name="description" content="' + description + '">',
        canonical && '<link rel="canonical" href="' + BASE + canonical + '">',
        robots && '<meta name="robots" content="' + robots + '">',
        '</head>',
        '<body>',
        body,
        script && '<script>' + script + '</script>',
        '</body>',
        '</html>',
    ]
        .filter(Boolean)
        .join('\n');
}

const routes = {
    '/': {
        html: page({
            title: 'Acme Shoes: Running Shoes for Every Runner',
            description: 'Lightweight running shoes for road and trail, with free returns.',
            canonical: '/',
            body: [
                '<h1>Acme Shoes</h1>',
                '<a href="/products/blue-runner">Blue Runner</a>',
                '<span onclick="location.href=\'/sale\'">Summer sale</span>',
            ].join('\n'),
        }),
    },
    // Problem: a vague title and no meta description
    '/products/blue-runner': {
        html: page({
            title: 'Acme Shoes',
            canonical: '/products/blue-runner',
            body: '<h1>Blue Runner</h1>',
        }),
    },
    // Problem: a missing product that still answers "200 OK" (a soft 404)
    '/products/red-runner': {
        html: page({
            title: 'Acme Shoes',
            body: '<h1>Sorry, that product could not be found.</h1>',
        }),
    },
    // Problem: a redirect chain, /old-sale -> /sale-2025 -> /sale
    '/old-sale': {redirect: '/sale-2025'},
    '/sale-2025': {redirect: '/sale'},
    '/sale': {
        html: page({
            title: 'Summer Sale: Up to 40% Off Running Shoes | Acme Shoes',
            description: "Save up to 40% on last season's running shoes until August 31.",
            canonical: '/sale',
            body: '<h1>Summer sale</h1>',
        }),
    },
    // Problem: a noindex header nobody can see in the page itself
    '/about': {
        headers: {'X-Robots-Tag': 'noindex'},
        html: page({
            title: 'About Acme Shoes',
            description: 'How a two-person workshop became a running shoe brand.',
            canonical: '/about',
            body: '<h1>About us</h1>',
        }),
    },
    // Problem: a canonical tag that points to the home page
    '/blog/choosing-trail-shoes': {
        html: page({
            title: 'How to Choose Trail Running Shoes | Acme Shoes',
            description: 'Grip, drop and fit: what to look for in a trail running shoe.',
            canonical: '/',
            body: '<h1>How to choose trail running shoes</h1>',
        }),
    },
    // Problem: the content only exists after JavaScript runs
    '/catalog': {
        html: page({
            title: 'All Running Shoes | Acme Shoes',
            description: 'Browse every Acme running shoe.',
            canonical: '/catalog',
            body: '<div id="app">Loading...</div>',
            script:
                "fetch('/api/products').then((r) => r.json()).then((products) => {" +
                "document.getElementById('app').innerHTML = products.map((p) => '<h2>' + p + '</h2>').join('');" +
                '});',
        }),
    },
    '/api/products': {
        type: 'application/json',
        html: JSON.stringify(['Blue Runner', 'Trail Grip 2', 'City Glide']),
    },
    // Problem: "Disallow: /blog" blocks every path that starts with /blog
    '/robots.txt': {
        type: 'text/plain',
        html: 'User-agent: *\nDisallow: /blog\n',
    },
};

http
    .createServer((req, res) => {
        const path = new URL(req.url, BASE).pathname;
        const route = routes[path];

        if (!route) {
            res.writeHead(404, {'Content-Type': 'text/html; charset=utf-8'});
            return res.end(page({title: 'Page not found', body: '<h1>Page not found</h1>'}));
        }
        if (route.redirect) {
            res.writeHead(301, {Location: route.redirect});
            return res.end();
        }
        res.writeHead(200, {
            'Content-Type': (route.type || 'text/html') + '; charset=utf-8',
            ...route.headers,
        });
        res.end(route.html);
    })
    .listen(PORT, () => console.log('Practice site running at ' + BASE));
“routes”中的每个键都是一个页面地址。以”Problem:”开头的注释说明了每个页面存在的问题。
在文件所在目录启动服务器:
# node server.js
一切正常的话,应该会看到如下内容:

图.1 使用 node 启动练习网站
保持服务器运行,并打开第二个终端窗口来执行后续命令。如果修改了 server.js,请先按 Ctrl+C 停止服务器,然后再重新启动。
查看页面的 HTTP 状态码
记得我刚开始构建网站时,曾尝试开发过各种各样的小项目。有一次,服务器端出现了问题,我在浏览器的”网络”(Network)选项卡中发现它返回了 500 错误。还有一次,我特意删除了一个页面,想看看会收到 404 错误还是其他问题。在自己构建的网站上进行各种尝试,能从结果中学到很多东西。
HTTP 状态码是搜索引擎首先读取的信息。它们是服务器与客户端(例如浏览器)进行”沟通”的方式。这些状态码分为五个区间:1xx、2xx、3xx、4xx 和 5xx。例如,5xx 状态码代表服务器端出现了问题,而 4xx 状态码则代表客户端出现了问题。
404 是最常见的错误,意味着网站上的某个页面无法找到。我们经常会遇到 404 错误,而解决它的方法通常就是做好网站维护,并确保链接有效。
本教程中将涉及的状态码包括:
- 200 OK:页面在此
- 301 Moved Permanently(永久移动):页面已移至其他地址
- 404 Not Found(未找到):此处没有页面
根据 Google 关于 HTTP 状态码的文档,Google 不会索引返回 4xx 状态码的网址(URL)。
若要查看练习站点主页的状态码,则使用带有”-I”(仅显示首部信息)和”-s”(隐藏 curl 的进度显示)参数的 crul 命令:
# curl -sI http://localhost:8080/
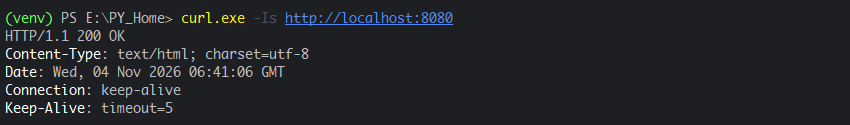
图.2 查看练习网站状态码
现在,请求一个未包含在路由中的地址,看看 404 响应是什么样的:
# curl -sI http://localhost:8080/products/does-not-exist
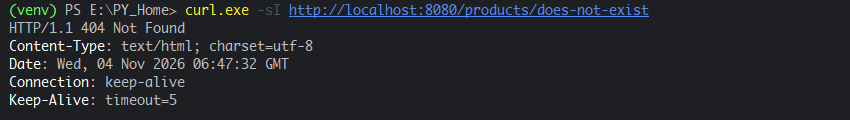
图.3 查看 404 响应状态码
在浏览器中打开开发者工具(按 F12 键,或在 Mac 上按 Cmd+Option+I),切换至”网络(Network)选项卡,然后重新加载页面。”状态”(Status)列会显示相应的代码。
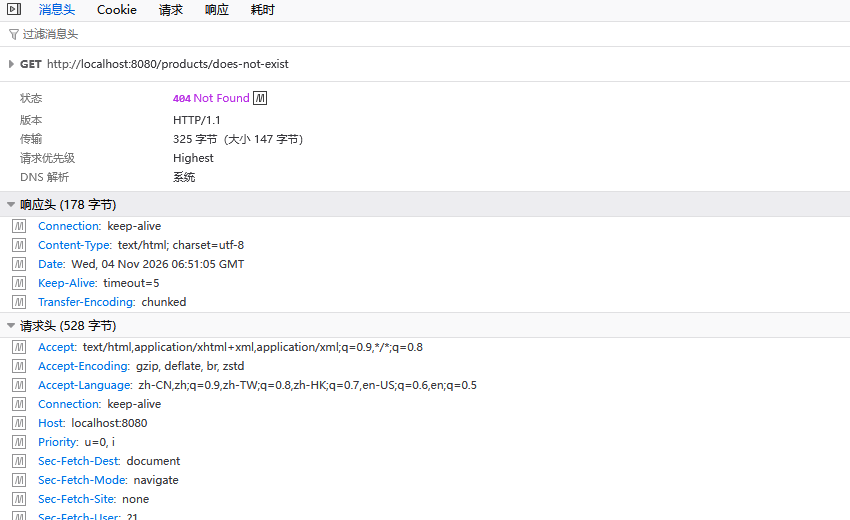
图.4 使用浏览器开发者工具查看响应头
“软 404″(Soft 404)?
假如要查看一款商店已不再销售的产品:
# curl -sI http://localhost:8080/products/red-runner
得到的状态码如下:
HTTP/1.1 200 OK
Content-Type: text/html; charset=utf-8
Date: Wed, 04 Nov 2026 06:59:08 GMT
Connection: keep-alive
Keep-Alive: timeout=5
在浏览器中,同一个页面显示:”Sorry, that product could not be found.”。
“软 404″(soft 404)本质上属于”页面未找到”的情况,但服务器返回的状态码却是 200。这会误导 Google:因为该网址依然存在,但页面上的内容已不再有效。
要解决这个问题,请确保缺失的页面返回真实的 404 状态码——这也是 Google 所推荐的做法。在示例站点中,从路由(routes)配置里删除”/products/red-runner”这一条目,这样服务器在访问该路径时就会返回 404。
失效链接(死链)同样会导致用户陷入”死胡同”。因此,请勿保留指向不存在内容的链接。应及时更新这些链接,使其指向内容相似的页面,或者指向确实存在的页面。
如果页面发生了迁移,请设置从旧地址到新地址的 301 重定向。只有当页面确实已彻底移除时,返回 404 才是正确的处理方式。
发现并修复”重定向链接”
重定向本质上是指将一个 URL(例如某个已失效的地址)指向另一个 URL(即有效的地址)。例如,如果将域名从 example-x.com 更改为 example-y.com,则通常会设置重定向,以便让所有访问 example-x.com 的用户自动跳转至 example-y.com。
重定向本身并无不妥,使用得当还能带来很大帮助。301 重定向表示页面已永久迁移,而 302 重定向则表示页面仅为临时迁移。谷歌(Google)在关于重定向的文档中详细说明了其处理各类重定向的方式:其爬虫程序最多可追踪 10 次重定向跳转。
然而,当一个旧地址(比如之前使用的域名)指向一个新地址,而该新地址又指向另一个地址,如此反复……就形成了所谓的”重定向链”。少量的重定向跳转尚可接受,但如果跳转次数达到五、六甚至七次,就会引发严重的问题。
下方命令可展示重定向链中的每一个环节,添加”-L”参数,让”curl”工具能够自动跟随重定向跳转:
# curl -sIL http://localhost:8080/old-sale
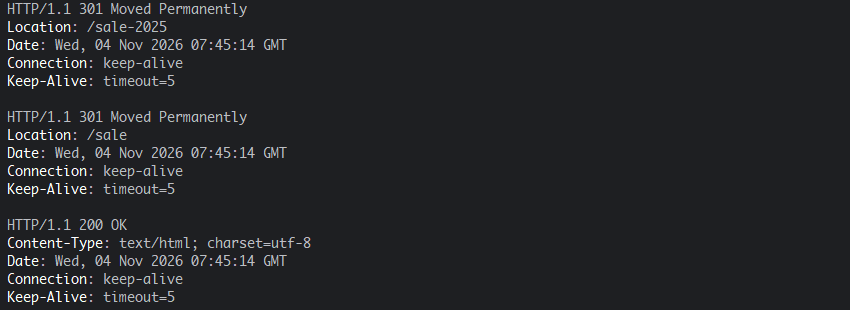
图.5 使用 crul 命令跟踪重定向环节
/old-sale 会跳转至 /sale-2025,进而跳转至 /sale。总结跳转的命令如下:
# curl -sL -o /dev/null -w "%{num_redirects} redirects, ended at %{url_effective}\n" http://localhost:8080/old-sale
2 redirects, ended at http://localhost:8080/sale
-o /dev/null 参数指示 curl 不要将页面 HTML 内容写入任何地方,从而避免其填满终端界面,仅输出一行摘要信息。”-w”参数则用于设定该摘要信息的内容。
若要解决此问题,可将旧地址(即原始地址)直接指向最终页面:
'/old-sale': { redirect: '/sale' },
修改好代码后,重启服务器并再次运行摘要。则会显示有 1 次重定向,最终到达 http://localhost:8080/sale。
确保 robots.txt 文件未阻止重要页面
robots.txt 是网站向 Google 等搜索引擎(及其爬虫)告知哪些内容允许抓取、哪些位置允许访问的一种方式。
查看该示例网站的文件:
# curl -s http://localhost:8080/robots.txt
示例网站的”robots.txt”内容如下:
User-agent: *
Disallow: /blog
设置”Disallow: /blog”存在风险,因为它会阻止爬虫抓取所有以”/blog”开头的路径。而通常情况下,正是这些文章在为网站带来最多的推广效果。
Google 的 robots.txt 文档中也给出了类似的例子:”Disallow: /fish”不仅会禁止访问”/fish”,还会同时屏蔽 “/fish.html”和”/fishheads”。
若要修正此问题,则确保规则仅针对我们确实想要屏蔽的内容——例如,仅屏蔽存放草稿的文件夹:
User-agent: *
Disallow: /blog-drafts/
在练习站点中,修改’/robots.txt’条目对应的 HTML 行:
html: 'User-agent: *\nDisallow: /blog-drafts/\n',
robots.txt 控制的是抓取(crawling),而非索引(indexing)。谷歌明确指出,它并非将页面从谷歌搜索结果中剔除的机制;若要实现这一目的,则需要使用 noindex 标签。
如果其他页面包含指向某个 URL 的链接,那么即便该 URL 在 robots.txt 中被屏蔽,它仍可能出现在搜索结果中(通常不显示描述)。谷歌只是不去读取该页面上的具体内容而已。
发现被意外设置的 noindex 标签
noindex 标签会告知 Google 不要索引特定页面。如果该标签出现在我们希望被索引并参与排名的页面(例如产品页面或首页)上,就会产生负面影响。
不过,对于那些无需参与排名或对网站价值贡献不大的页面(如登录、注册页面),使用 noindex 标签则是有益的。
只有当爬虫能够访问页面并读取到该规则时,noindex 标签才会生效。如果 robots.txt 文件屏蔽了相应的 URL,Google 就无法看到 noindex 标签,该页面仍可能出现在搜索结果中。因此,如果希望某个页面不被 Google 收录,应使用 noindex 标签,并确保该页面仍可被爬虫抓取。
检查 Robots Meta 标签
第一种方式是查看页面”<head>”部分中的标签:
<meta name="robots" content="noindex">
也可以在页面中搜索该关键词:
# curl -s http://localhost:8080/about | grep -i noindex
在”关于”(About)页面上,该命令不会输出任何内容。当然,也可以在页面上点击鼠标右键,选择”查看页面源代码”(View Page Source),然后搜索”noindex”。
修复”noindex”标签非常简单,只需将其移除,搜索引擎便可对该页面进行索引。
在页面代码或模板中,以及内容管理系统(CMS)或 SEO 插件的设置里查找该标签。在 WordPress 中,若勾选了”建议搜索引擎不索引本站点”(Discourage search engines from indexing this site)这一选项,系统就会将该标签添加到所有页面中。
检查 X-Robots-Tag 响应头
第二种方式是通过 HTTP 响应头(HTTP header)。检查”关于”(About)页面的响应头:
curl -sI http://localhost:8080/about
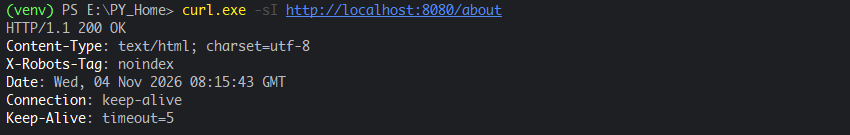
图.6 查看 X-Robots-Tag 响应头
该标记不会出现在”查看网页源代码”(View Page Source)中,仅存在于 HTTP 响应头里。若要在练习站点中修复此问题,需要删除针对”/about”路径所配置的响应头信息。若是在实际网站中遇到此情况,请检查服务器配置、托管服务商提供的响应头设置,以及所使用的任何 SEO 插件。
正确使用规范标签
如果我们有多个页面内容大同小异,但又缺乏足够的差异性,那么需要指定一个主页面。规范标签可以告诉搜索引擎哪个页面才是主页面。
同样,同一个页面也可以存在于多个网址中:
https://example.com/blog/choosing-trail-shoes
https://example.com/blog/choosing-trail-shoes?utm_source=newsletter
https://www.example.com/blog/choosing-trail-shoes
这三个地址对应的是同一篇文章,其中第一个是主地址,也就是我们希望谷歌在搜索结果中展示的那个地址。因此,这三个地址都包含相同的规范标签(canonical tag),指向该主页面:
<link rel="canonical" href="https://example.com/blog/choosing-trail-shoes">
当 Google 在包含”?utm_source=newsletter”参数的页面版本中发现此标签时,它便会识别出该页面是原始地址页面的副本。原始地址页面本身也包含同样的标签,指向其自身。这被称为”自指向规范化标签”(self-referencing canonical tag),其含义是:”我才是主版本。”
Google 将其视为一种强有力的参考信号,而非强制指令。如果决定使用规范化标签,那么在每个主页面上设置一个指向自身的规范化标签是一种良好的做法,Google 也对此予以推荐。
当然,也完全不必非要使用规范化标签。Google 表示,指定规范化页面并非强制要求;若未指定,Google 会自行选择它认为最适合展示给用户的版本。当相同或高度相似的内容可以通过多个不同的网址(例如上述三个地址)访问时,使用规范化标签便是一个明智的选择。
修复缺失或重复的标题(Title)与元描述(Meta Description)
优秀的标题或元描述长度适中,内容精炼,能简明扼要地概括页面主题。它们好比页面的核心精髓,起到了介绍页面的作用。
以 Blue Runner 的产品页面为例:
# curl -s http://localhost:8080/products/blue-runner | grep -i -E "<title>|name=\"description\""
<title>Acme Shoes</title>
该标题未能反映页面内容,且完全缺失了描述信息。在 PowerShell 中,可以使用”| Select-String ‘<title>|name=”description” ” 来进行检查。
谷歌关于标题和摘要的指南建议:每个页面都应具备独特且具有描述性的标题及描述内容。
若要在练习站点中修复此问题,可以将”/products/blue-runner”条目中的标题行替换为:
title: 'Blue Runner Road Running Shoe | Acme Shoes',
description: 'A lightweight road running shoe with a cushioned sole and free returns.',
如何让链接可被抓取
查看练习网站的首页:
# curl -s http://localhost:8080/

<!doctype html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Acme Shoes: Running Shoes for Every Runner</title>
<meta name="description" content="Lightweight running shoes for road and trail, with free returns.">
<link rel="canonical" href="http://localhost:8080/">
</head>
<body>
<h1>Acme Shoes</h1>
<a href="/products/blue-runner">Blue Runner</a>
<span onclick="location.href='/sale'">Summer sale</span>
</body>
</html>
本页面上的其他内容均无问题:标题、描述、规范链接(canonical tag)以及”Blue Runner”链接——后者是一个包含”href”属性的有效<a>元素。唯一的问题在于”Summer sale”(夏季促销)这一<a>标签。
<a> 标签本质上属于非语义化 HTML,即它本身不具备任何特定含义。而真正的链接则具有明确含义:搜索引擎和屏幕阅读器都能识别出它是一个链接。
哪些链接需要能够被抓取呢?简单来说,就是所有我们希望搜索引擎能够”看到”的内容——例如你销售的产品、文章、课程以及其他类似内容。
根据 Google 的链接准则,只有包含”href”属性的 <a> 元素才能被可靠地抓取。
若要在练习网站中修复此问题,请将该 <a> 所在行替换为:
'<a href="/sale">Summer sale</a>',
检查网站内容是否需要 JavaScript 才能显示
在客户端渲染(Client-side Rendering)模式下,JavaScript 必须先加载,其他内容才能随之加载。
JavaScript 通常用于构建产品列表、价格、评论和菜单等元素。如果缺少 JavaScript,客户端渲染的页面往往只会显示加载提示或空白区域。
虽然 Google 确实会执行 JavaScript,但这一过程发生在后续阶段。页面需要先在渲染队列中等待(可能耗时数秒甚至更久);如果脚本执行失败或被拦截,渲染后的页面可能就会缺失核心内容。
正因如此,服务端渲染(Server-side Rendering)依然是一个明智的选择;对于关键内容,我个人更倾向于使用这种方式。Google 的 JavaScript 指南也持相同观点:服务端渲染能提升网站对用户和爬虫的加载速度,况且并非所有网络爬虫都能执行 JavaScript。
采用服务端渲染时,HTML 内容会直接发送至浏览器,JavaScript 随后才进行渲染。
无论是哪种构建方式,Google 都能对其进行索引。Google 的爬虫会使用最新版本的 Chrome 来执行 JavaScript,因此,想要被 Google 索引,并不强制要求必须使用服务端渲染。
接下来的测试旨在检查:在没有 JavaScript 的情况下,重要内容是否依然可见。虽然这无法完全反映 Google 所看到的内容(因为 Google 会执行 JavaScript),但它能展示任何爬虫在 JavaScript 执行前所获取到的原始数据。
在浏览器中打开 http://localhost:8080/catalog,会看到三个产品。现在,尝试使用”curl”工具下载该页面(因为 curl 不会执行 JavaScript):
# curl -s http://localhost:8080/catalog | grep -i "trail grip"
这段代码不会输出任何内容,因为服务器发送的 HTML 中并不包含产品名称。在”<body>”标签内,服务器仅发送了以下内容:
<div id="app">Loading...</div>
<script>fetch('/api/products').then((r) => r.json()).then((products) => {document.getElementById('app').innerHTML = products.map((p) => '<h2>' + p + '</h2>').join('');});</script>
如果不使用 curl,我们也可以在浏览器中选择”查看网页源代码”。在该页面中,就会看到”Loading…”以及上述脚本,但找不到任何产品名称——这是因为这些内容是在 JavaScript 运行之后才由浏览器添加进去的。
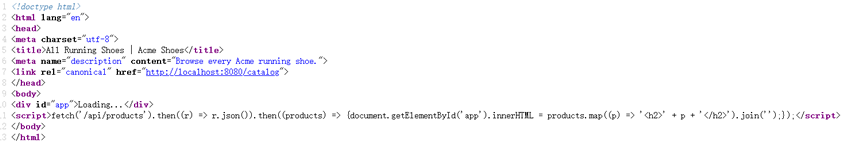
图.7 使用浏览器查看网页源代码 js 文件加载情况
若想查看 Google 渲染后的页面效果,可以使用 Google 提供的工具对在线页面进行测试。在 Search Console 中,可以使用”网址检查”(URL Inspection)工具进行实时测试(点击”测试实时网址”,然后选择”查看测试后的页面”),从而查看 Google 渲染出的 HTML 代码及页面截图。
对于任何公开页面,”富媒体搜索结果测试”(Rich Results Test)工具也能展示渲染后的 HTML。Google 建议使用上述两种工具来排查 JavaScript 相关问题。由于这些工具无法访问”localhost”(本地主机),请务必在正式网站上进行测试。
如果希望产品名称从一开始就包含在 HTML 中,那么就需要在服务器端进行渲染。在练习网站中,请在路由(routes)定义之前添加产品列表:
const products = ['Blue Runner', 'Trail Grip 2', 'City Glide'];
将目录的主体及脚本行替换为:
body: '<div id="app">' + products.map((p) => '<h2>' + p + '</h2>').join('') + '</div>',
而在”/api/products”条目中:
html: JSON.stringify(products),
重启服务器并再次运行 curl 命令,就会看到如下内容:
<div id="app"><h2>Blue Runner</h2><h2>Trail Grip 2</h2><h2>City Glide</h2></div>
之所以能这样,是因为服务器在发送页面之前,就已经将产品名称写入了 HTML 中。任何爬虫(即使是无法运行 JavaScript 的爬虫)都能看到这些内容;同时,我们依然可以使用 JavaScript 来实现交互功能。
是否可以在短时间内检查完成一个页面
说实话,这非常困难。页面可能存在诸多问题,短时间不可能完成全面检查。
若想真正找出问题所在,就需要进行全面检查——例如使用 Google PageSpeed Insights。如果该网站归你所有,还可以利用 Google Search Console 中的”网址检查”(URL Inspection)工具。
本教程中介绍的以下命令是一个不错的切入点:
- 使用”curl -sI”查看状态码及”X-Robots-Tag”响应头
- 对旧地址使用”curl -sIL”,以统计重定向次数
- 逐行检查”/robots.txt”文件
- 查看页面源代码,确认是否存在”noindex”标签、规范链接(canonical)、<title> 标题、<description>描述,以及页面中的重要内容。
在本教程中,我们修复了练习网站上的八个问题:软 404 错误、重定向链、robots.txt 规则问题、隐藏的 noindex 响应头、错误的规范标签(canonical tag)、模糊的标题及缺失的描述、爬虫无法追踪的链接,以及需要 JavaScript 才能加载的内容。
最重要的一点是,我们需要持续监测网站。定期进行扫描和维护,确保网站运行正常——尤其是在进行改进或调整时,更要格外留意。